Agent 的新变革在于人类注意力的重新分配
过去一段时间,我一直在看 2026 年几个 Agent 相关产品和技术方向,主要来自开发者社区和 X。大家已经不满足于仅仅用 vibe coding 来描述 AI 编程,开始寻找更准确的词,比如 agentic engineering;同时也出现了 “slop coding”“vibe slop” 这类反向词汇,用来批评低质量、缺少审查的 AI 生成代码。Business Insider 最近关于 vibe coding 命名争议的报道里,也提到 “agentic engineering” 被一些人视为更中性的替代表达。
OpenAI 发布 Codex App,把它定义成一个面向 agents 的 command center,用来同时管理多个 agents、并行运行任务,以及处理横跨数小时、数天甚至数周的长期任务。GitHub 把 Claude 和 OpenAI Codex 接入 Agent HQ,让开发者可以从 GitHub、GitHub Mobile 和 VS Code 里运行多个 coding agents 。Anthropic 在 2026 年讨论 agent evals、long-running harness 和 Managed Agents,并明确把 agent 看成 model 与 harness 共同工作的系统。ServiceNow 则把 AI Control Tower 扩展成企业级控制层,用来发现、观察、治理、保护和度量企业内的 AI agents、models 和 identities。
这些产品真正共同指向的,并不只是 Agent 更会干活。更重要的是:人类注意力正在被重新分配。
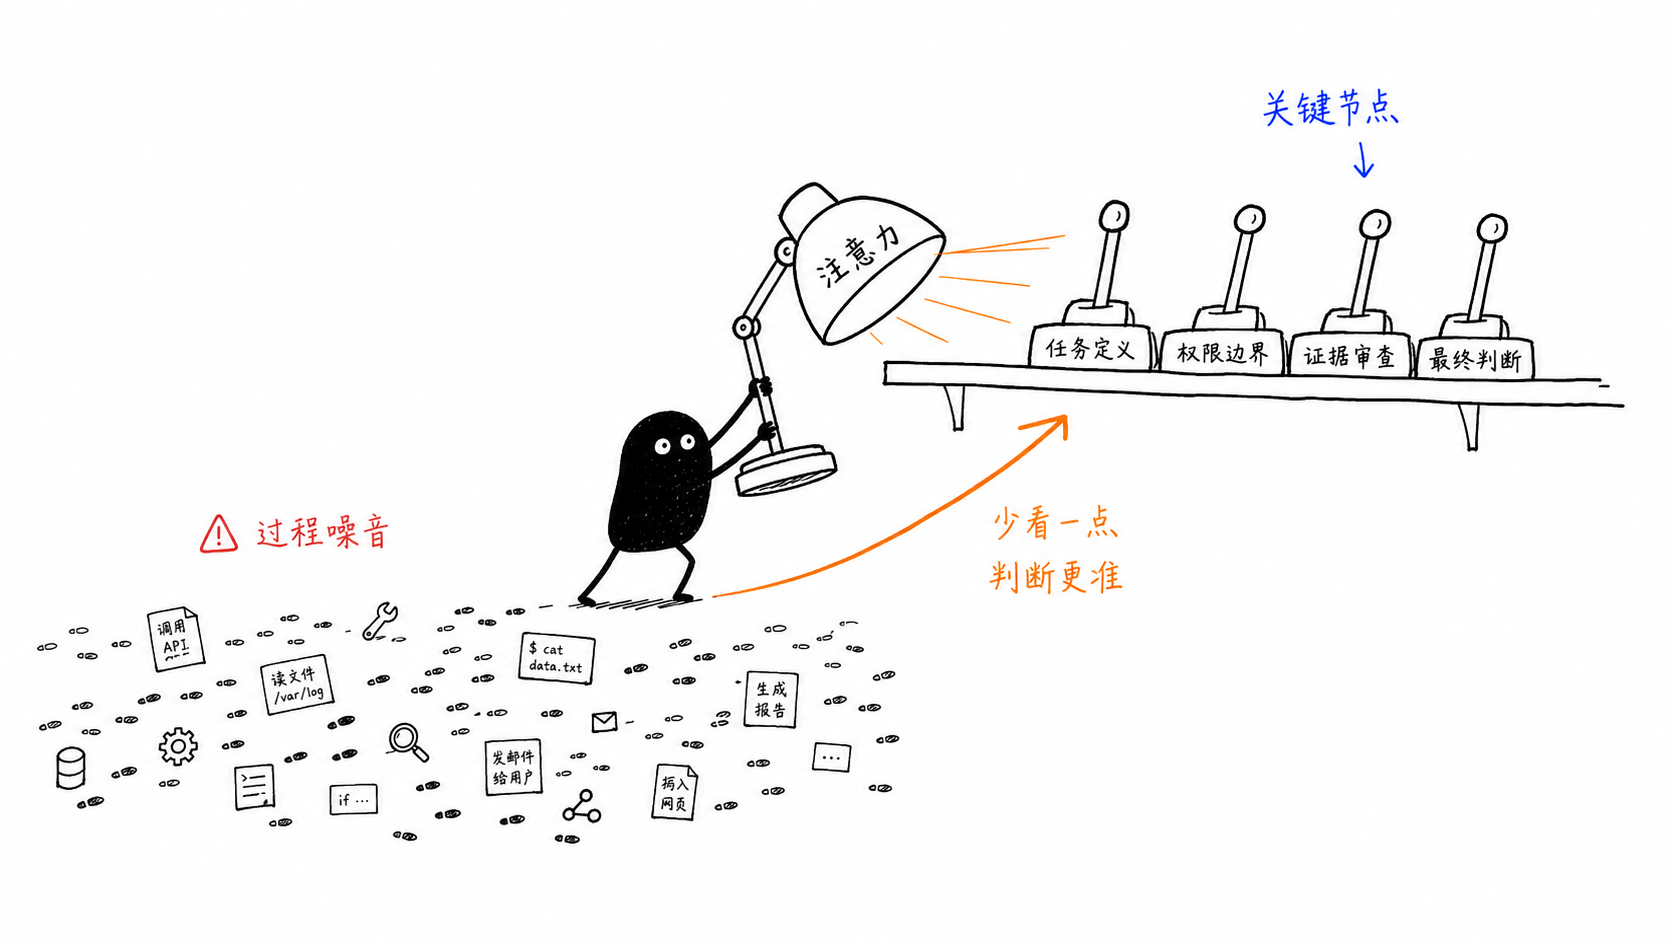
以前,人类工程师需要盯着 AI 的每一步输出、每一次工具调用、每一处代码修改。现在,Agent 开始承接更长、更复杂、更并行的执行过程,人类不可能再继续盯着全过程。因此人类的注意力必须从低层级的过程监督里抽离出来,重新分配到任务定义、权限边界、异常处理、证据审查和最终决策判断这些地方上。
所以我们应该讨论的不是“哪个 Agent 产品更强”,而是一个更底层的问题:
当 Agent 真的开始干活以后,人类应该把注意力放在哪里?
我的核心判断是:
Agent 的新变革,不只是自动执行能力增强,而是人类注意力从“盯过程”迁移到“管关键节点”。
为什么“AI 从助手到执行者”这个说法已经不够?
Microsoft 2026 Work Trend Index 里有一句很直接的话:当 AI 和 agents 承担更多 execution,人类自己的 agency 会扩大,人类会有更多空间去 direct the work、make the calls、own the outcomes。
但我觉得,这个说法只能解释第一层变化。如果 AI 只是回答问题,核心问题是:
模型回答得好不好?
而如果 AI 开始执行任务,问题就变成:
这个执行过程如何被组织?
如何被限制?
如何被观察?
如何被验证?
什么时候必须让人介入?
这是两类完全不同的问题,对于一次真实的软件工程,并不是“生成一段代码”这么简单。它通常包含:
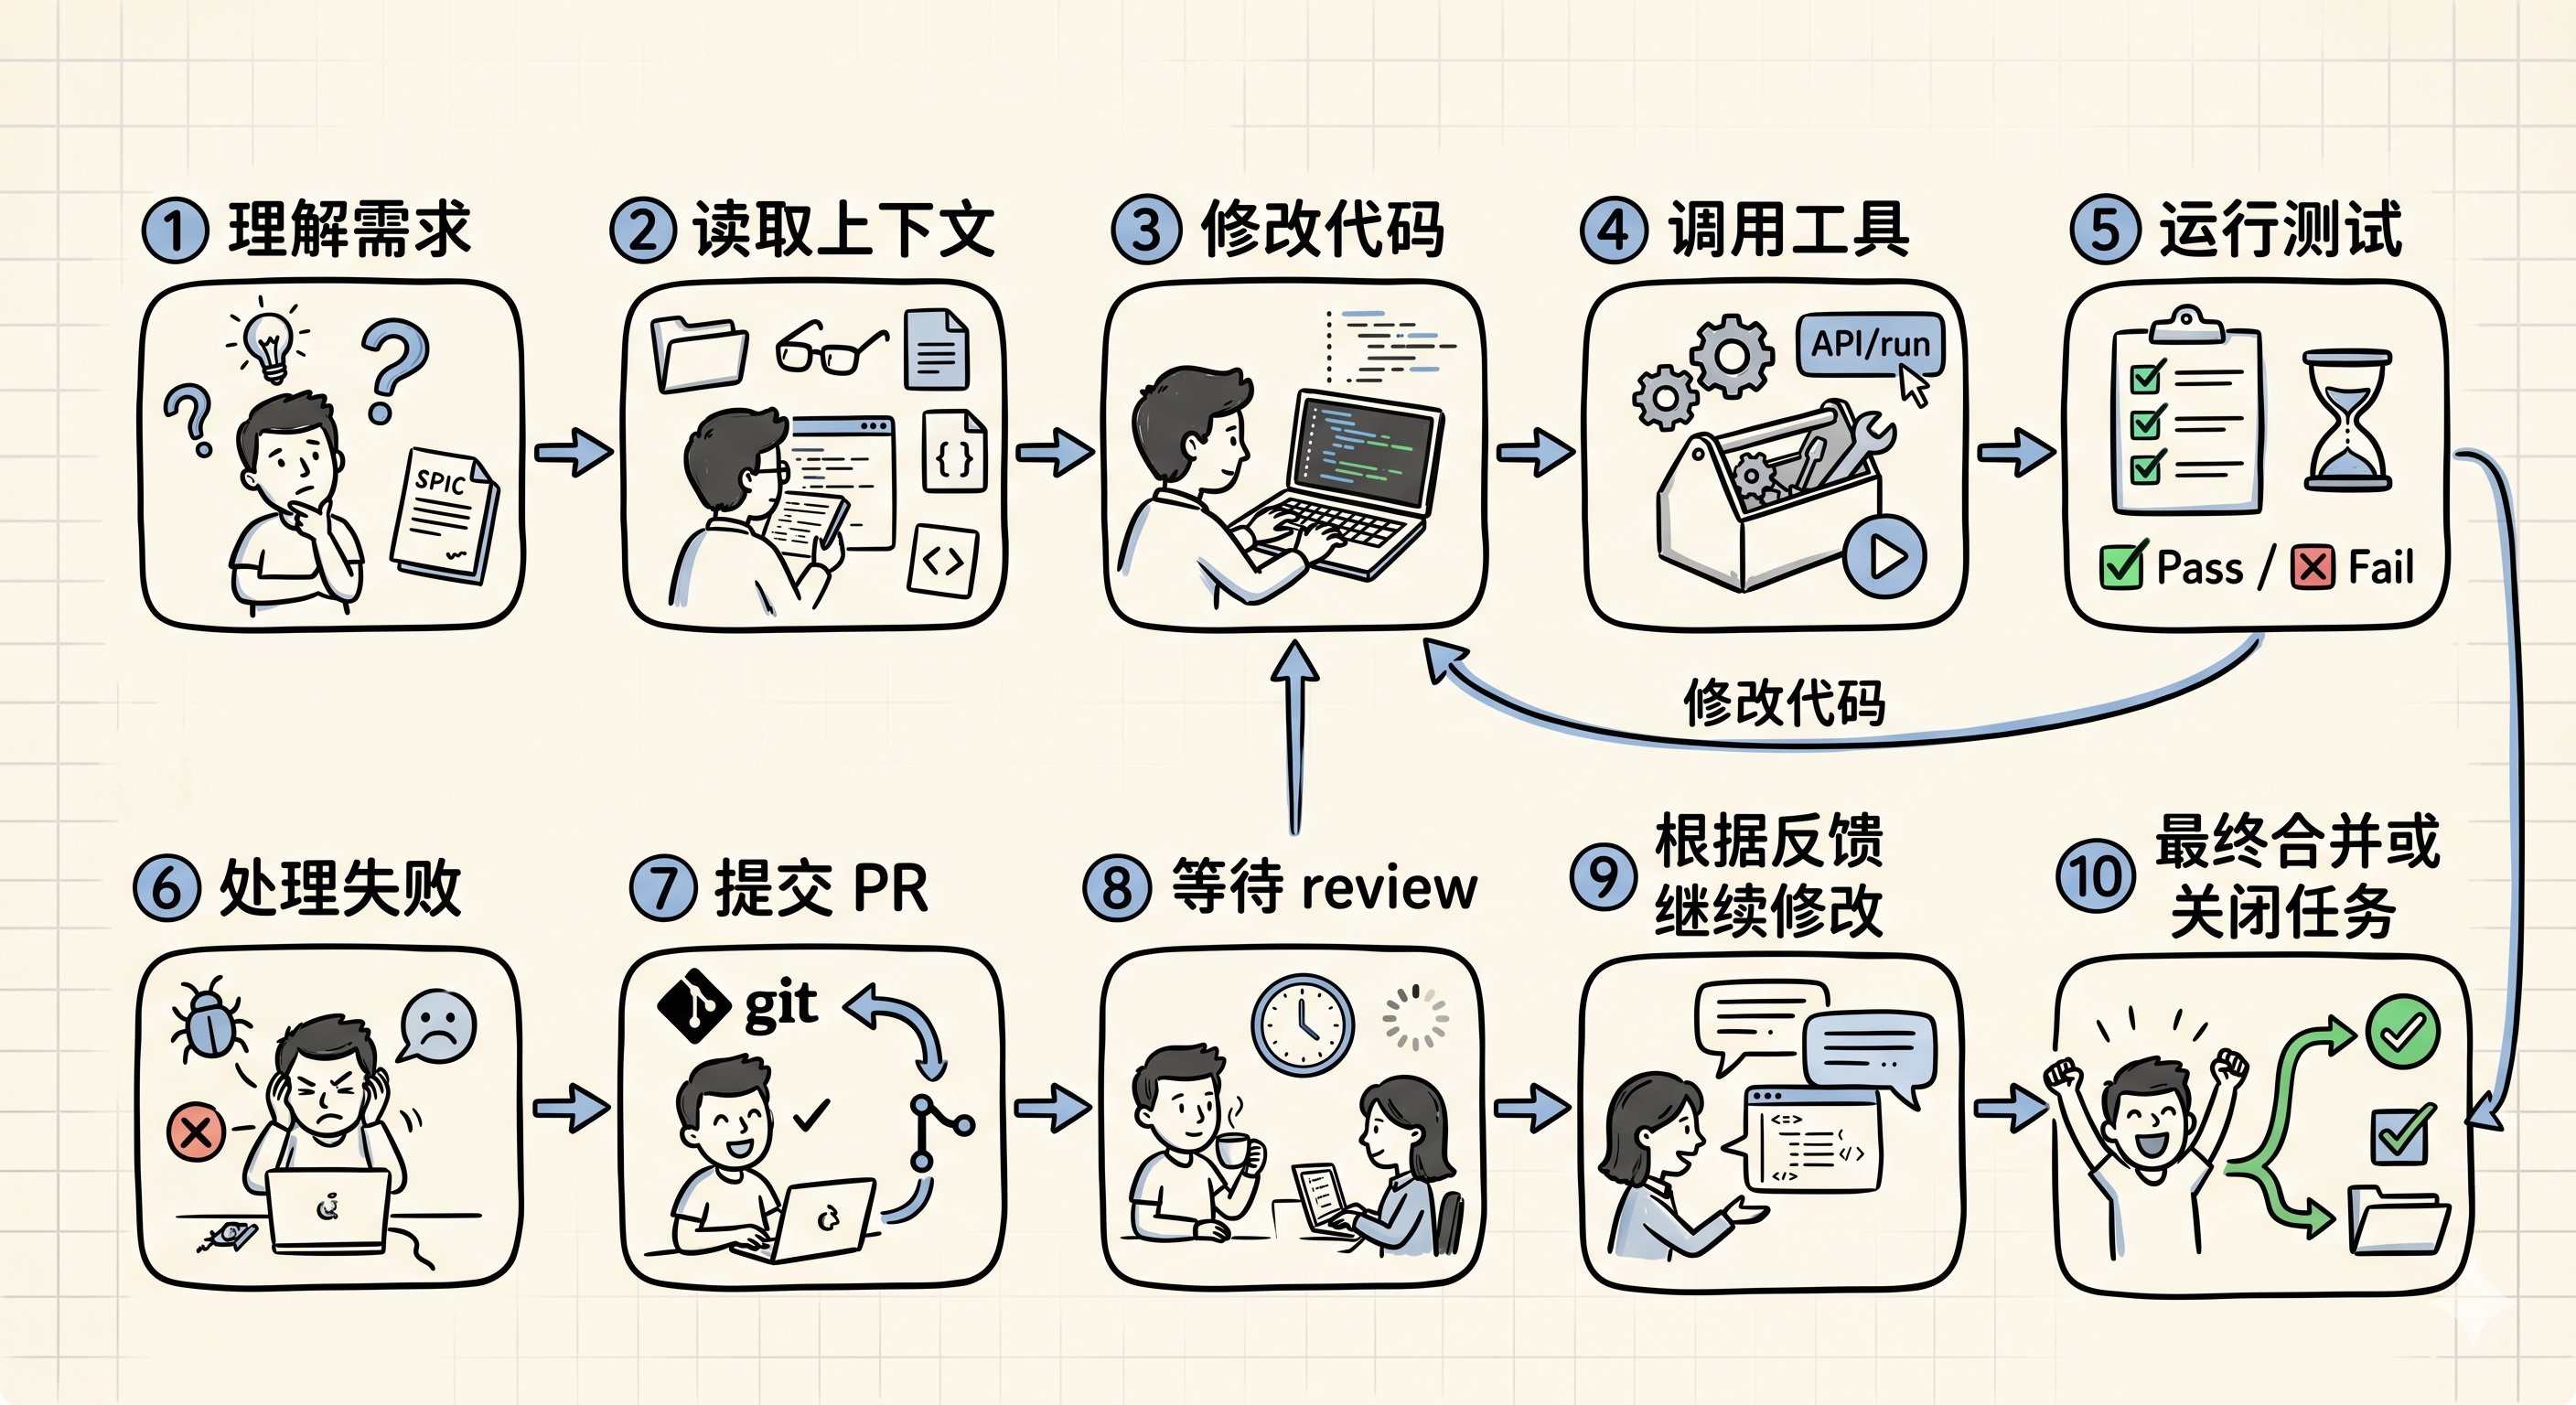
当这些动作由 Agent 执行时,人类如果还试图盯住每一步,会很快遇到注意力瓶颈。
所以我更倾向于这样描述 2026 年的 Agent 变化:
重点不只是 AI 变成执行者,而是执行过程开始被系统化;系统化的结果,是人类注意力被重新分配。
从 Vibe Coding 到 Agentic Engineering
Vibe coding 更像是在描述一种体验:人用自然语言描述需求,AI 生成代码,人跟着感觉不断试错。但这个词容易让人误解成“随便说几句,代码能跑就行”。这也是为什么最近会出现 “slop coding”“vibe slop” 这类批评性表达。
相比之下,agentic engineering 更接近我想讨论的东西。
GLM-5 的 2026 年论文标题直接用了 “from Vibe Coding to Agentic Engineering”,把范式迁移描述为从自然语言驱动代码生成,走向更长程、更自主、更复杂的软件工程任务。 另一篇 2026 年论文 Agentic Agile-V 也把问题说得很直接:agentic AI coding systems 可以 inspect repositories、plan implementation steps、edit files、call tools、run tests、submit pull requests,但核心问题已经不再是 prompt engineering,而是 engineering process control。
这正好和我的观察一致。
Agentic Engineering 不是“让模型多写代码”。它更像是在问:
任务如何定义?
上下文如何供给?
权限如何约束?
执行轨迹如何记录?
证据如何交付?
人类判断如何介入?
换句话说:
Agentic Engineering 的核心,不是代码生成,而是围绕 Agent 执行过程设计一套可控、可观测、可验证的人机工作系统。
从传统软件到 Agent Systems:我看到的核心转折
在传统软件工程里,我们早就习惯用确定性系统来组织执行。
CI/CD 知道什么时候拉代码、装依赖、跑测试、构建镜像、部署和回滚,任务队列知道什么时候重试,工作流引擎知道下一个节点是什么,权限系统知道谁能访问什么,日志系统能帮助我们还原一次执行……
Agent 出现以后,我们会很容易有一个冲动:
让模型自己决定下一步。
一个最朴素的 Agent 循环大概是这样:
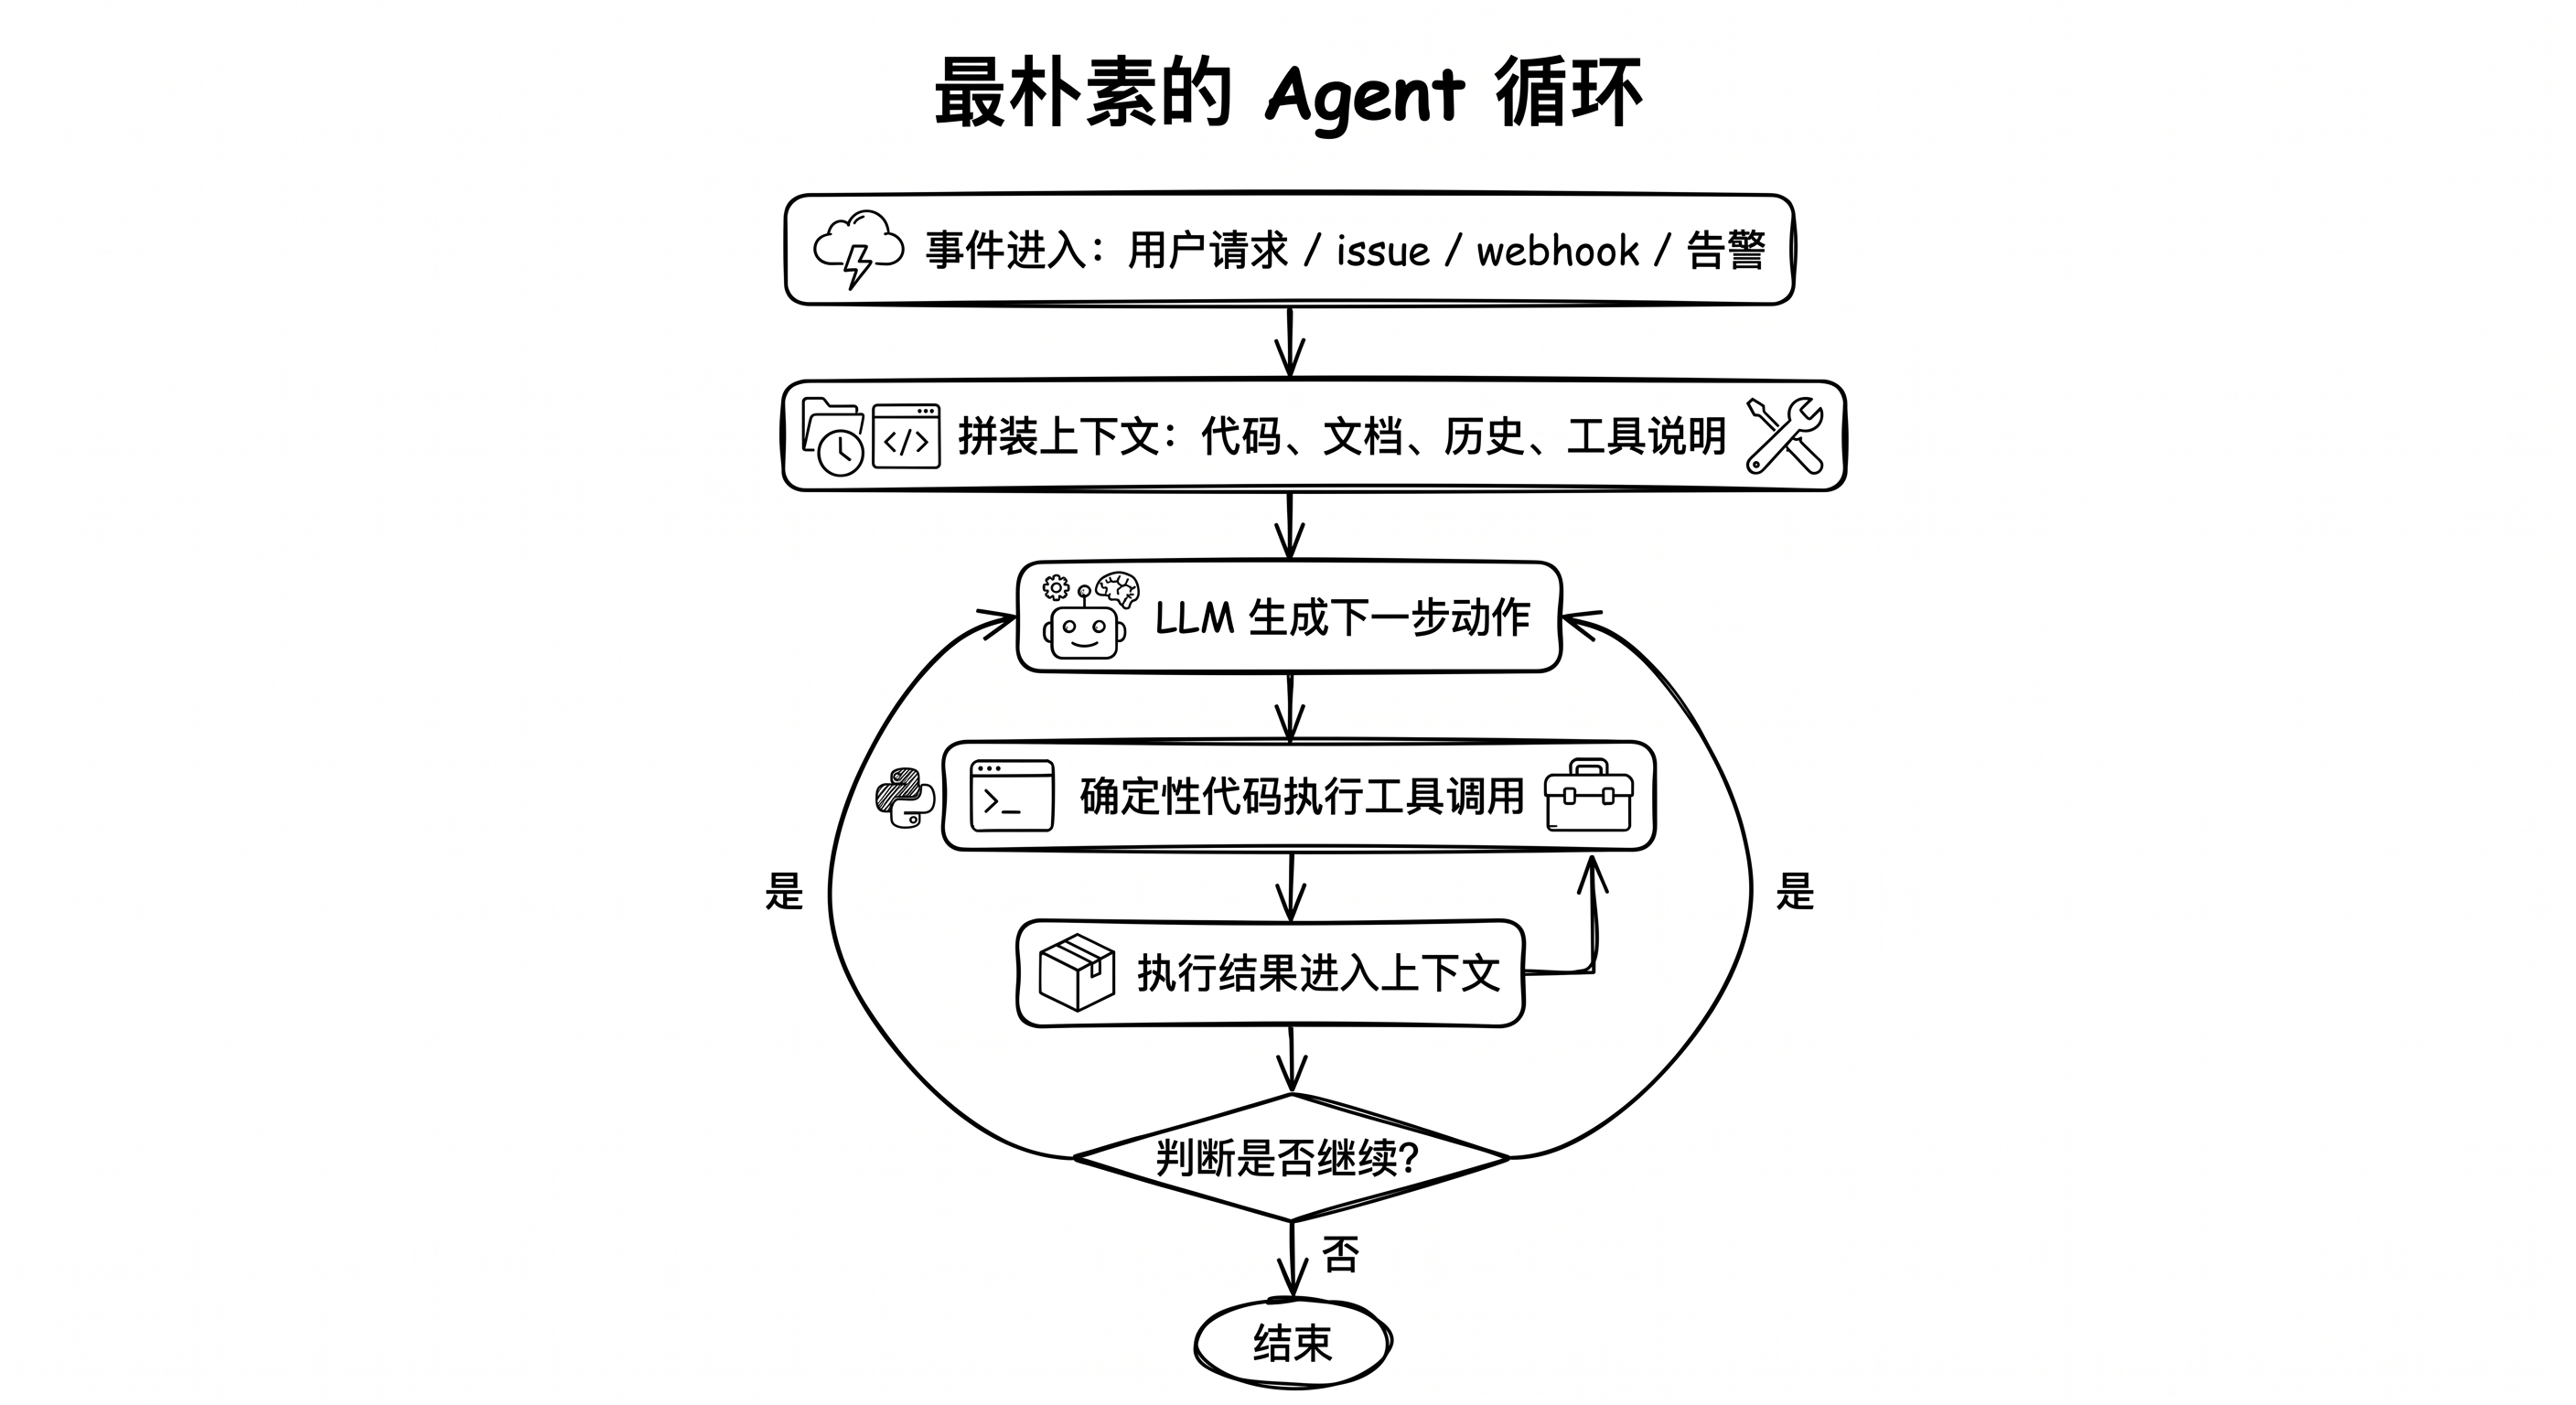
这个循环在 demo 阶段以及很多小型项目时很自然,但真实进入生产环境和大型工程实践中情况却并不那么理想,只要任务变长、上下文变大、工具变多、权限变复杂、Agent 数量变多,很容易暴露各种工程问题。
Anthropic 在 2026 年的 agent evals 文章里给了一个很有用的定义:agent harness 是让模型作为 agent 行动的系统,它处理输入、编排工具调用并返回结果;当我们评估一个 agent 时,本质上是在评估 harness 和 model 一起工作。
Anthropic 的 Managed Agents 进一步把 brain、hands 和 session 分开:brain 是 Claude 与 harness,hands 是 sandbox 和 tools,session 是事件日志。
这让我意识到一个很重要的点:
生产级 Agent 不是一个“模型自己循环直到完成”的黑盒,而是一个需要被工程化管理的执行系统。
而这个执行系统的最终目的,不只是让 Agent 多做事,而是让人类少盯无效过程,多看关键节点。
这个系统可以抽象成下面这条链:
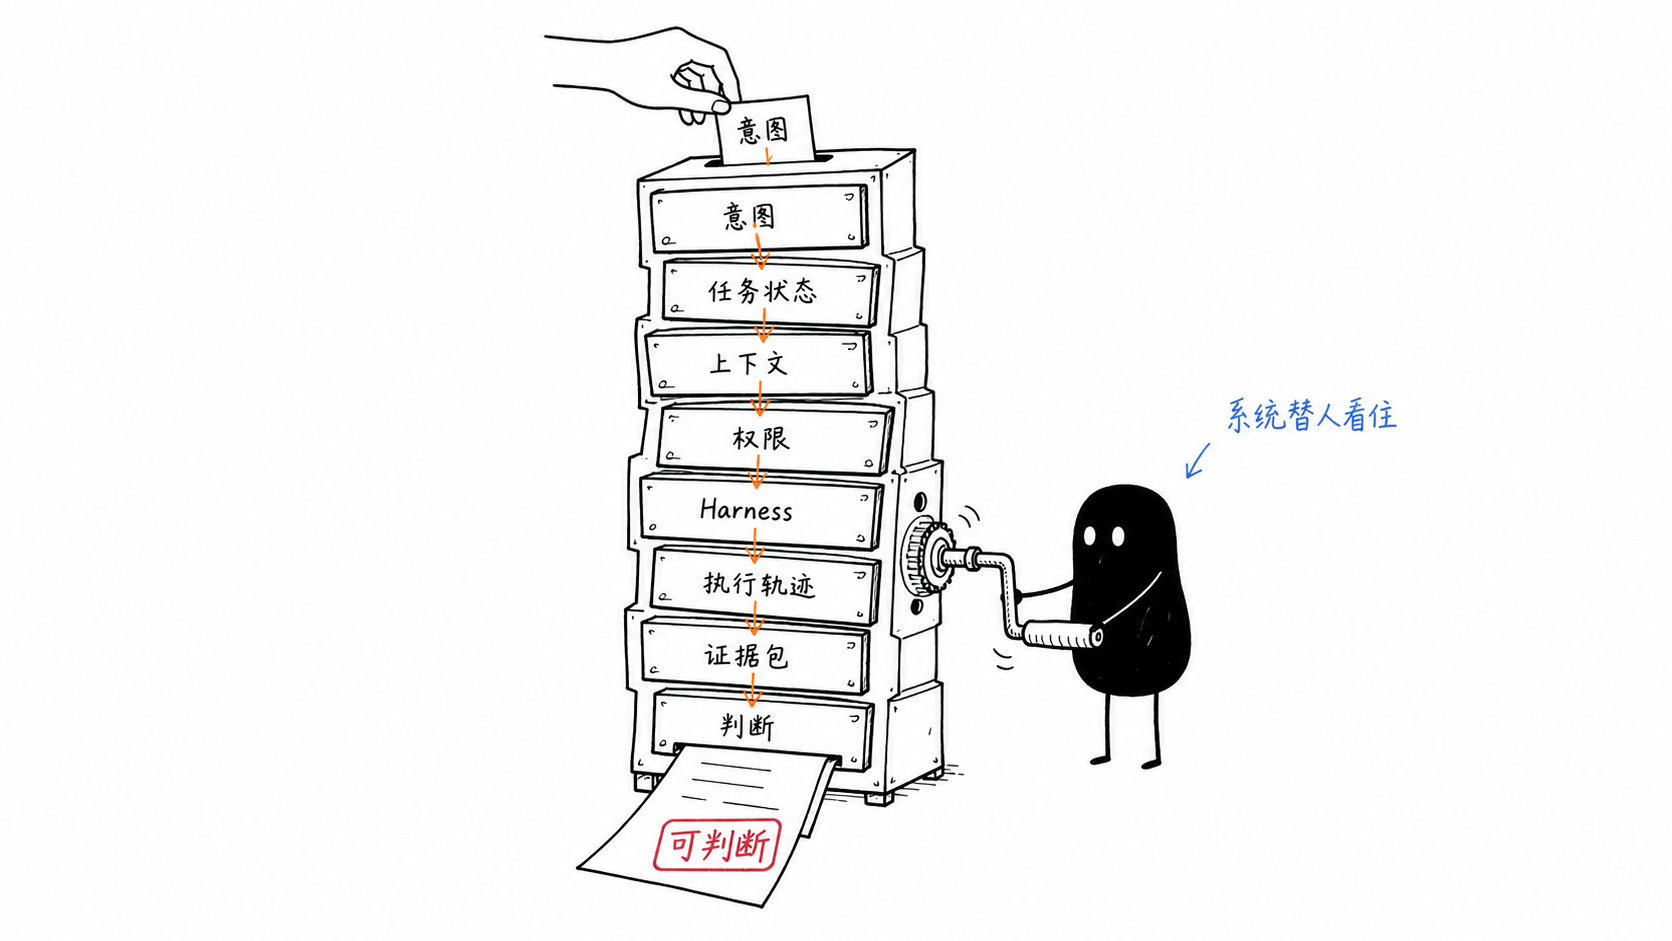
每一层本质上都在回答一个注意力问题:
人类是否还需要亲自盯这一层?
如果不需要,系统如何替人看住它?
如果需要,人类应该在什么时刻介入?
8个关键Factor
从 2026 年这些产品和资料里抽象出8个关键的变化:人类注意力如何从过程监督迁移到关键判断。
Factor 1:用任务状态替代聊天会话,让人知道该看哪里
过去使用 AI 工具时,默认单位是一个 chat session:
打开窗口
输入 prompt
追问几轮
拿到结果
结束
但 Agent 不是这样工作的,Agent 更像是在承接一个任务。这个任务应该可以被启动、暂停、恢复、观察、分支和验收。
OpenAI 在 2026 年4月发布 Symphony 时,提到 coding agents 使用 Linear 作为 state machine,并且 Symphony 把 work 从 sessions 和 pull requests 中解耦出来。有些 issue 会产生多个 PR,有些 issue 只是调查或分析,不一定触碰代码库。
GitHub 也在 2026 年把 agent activity 放进 Issues 和 Projects:当 Copilot、Claude 或 Codex 被分配到 issue 时,agent session 会显示在 assignee 下方,并展示 queued、working、waiting for review、completed 等实时状态,用户可以直接进入 session logs。
两个例子可以得出一个共同的信息点:
Agent 工作流的核心单位,可能不再是“会话”,而是“任务状态”。
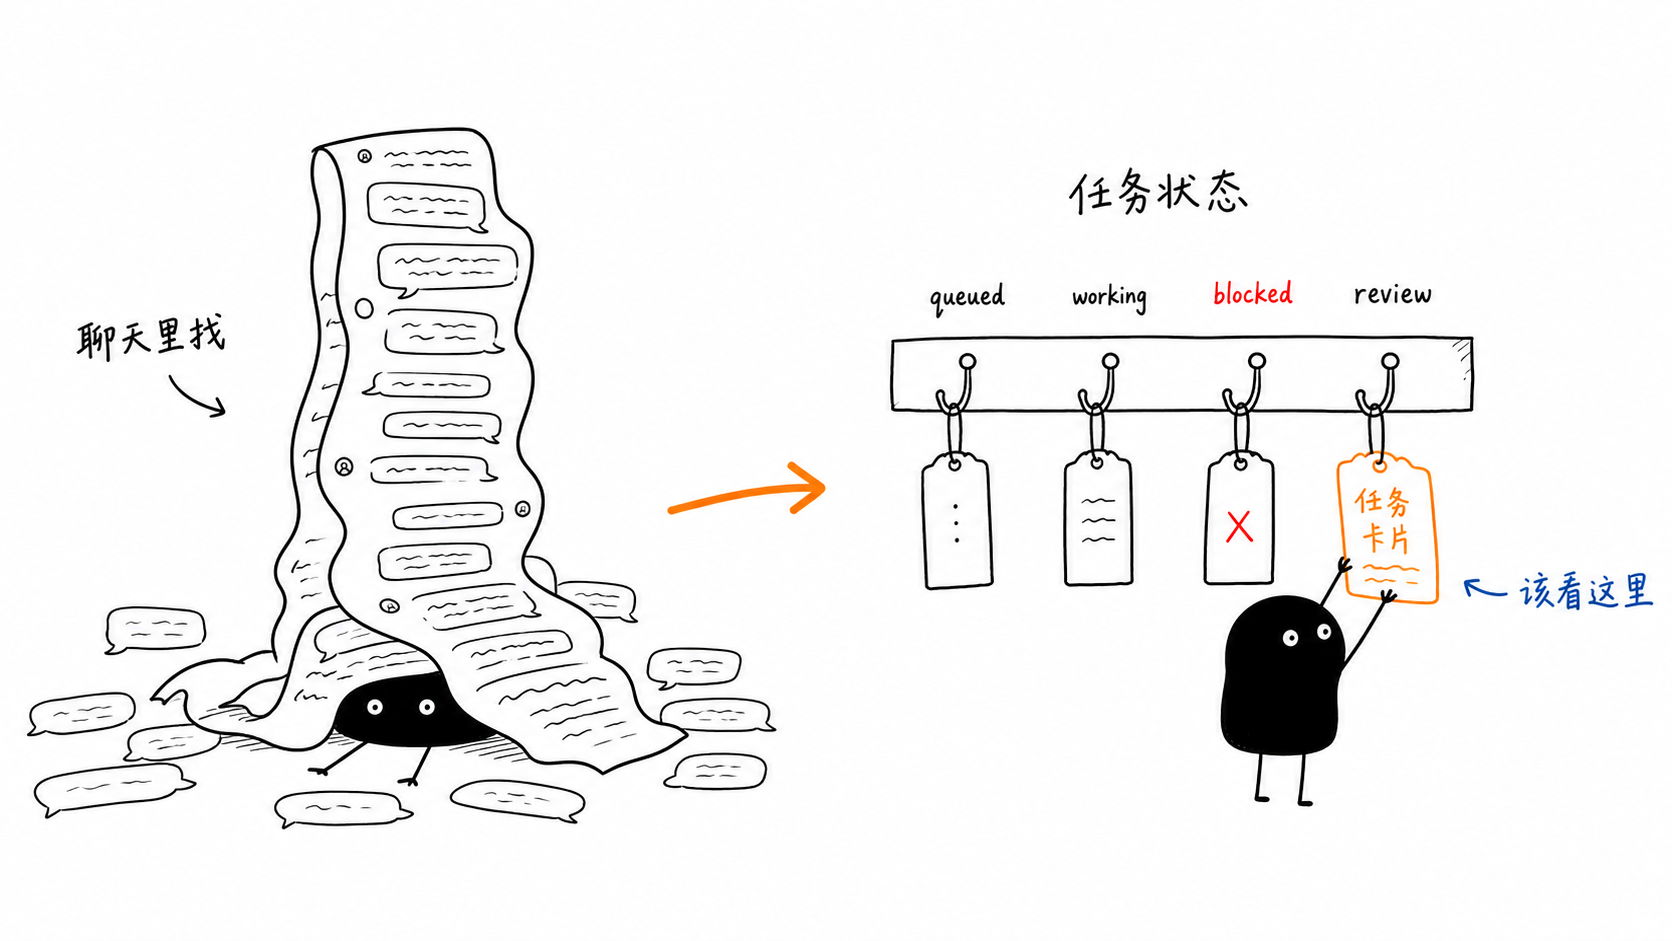
如果一切都藏在 chat session 里,人类只能靠翻对话来判断进展。但如果任务有状态,人类就可以只看几个关键点:
这个任务是否开始?
是否阻塞?
是否等待 review?
是否失败?
是否完成?
是否需要我决策?
一个适合 Agent 执行的任务,不能只写一句“帮我修一下这个 bug”。它至少应该包含:
目标
背景
非目标
相关文件
权限边界
当前状态
执行日志
阻塞点
测试方法
验收标准
这意味着,Issue 不再只是人类之间的沟通文本,它正在变成 Agent 的任务规格,也是在告诉人类:你应该把注意力放到哪个任务状态上。
Factor 2:用 Agent Harness 承接执行细节
Prompt 当然重要,但它只决定模型看到什么、怎么想。Agent 真正能不能稳定干活,更取决于它处在什么 harness 里。
OpenAI 在 Harness Engineering 文章里描述了一个 agent-first 开发实验:人类不直接写代码,而是设计环境、指定意图、构建反馈循环,让 Codex agents 做可靠工作;OpenAI 还明确说,这个实验的核心之一,是最大化真正稀缺的资源:human time and attention。 Anthropic 的 evals 文章也明确说,agent harness 负责处理输入、编排工具调用并返回结果。
所以我更愿意这样理解:
Prompt 决定 Agent 怎么想。
Harness 决定 Agent 怎么干活。
一个生产级 Agent harness 至少应该包括:
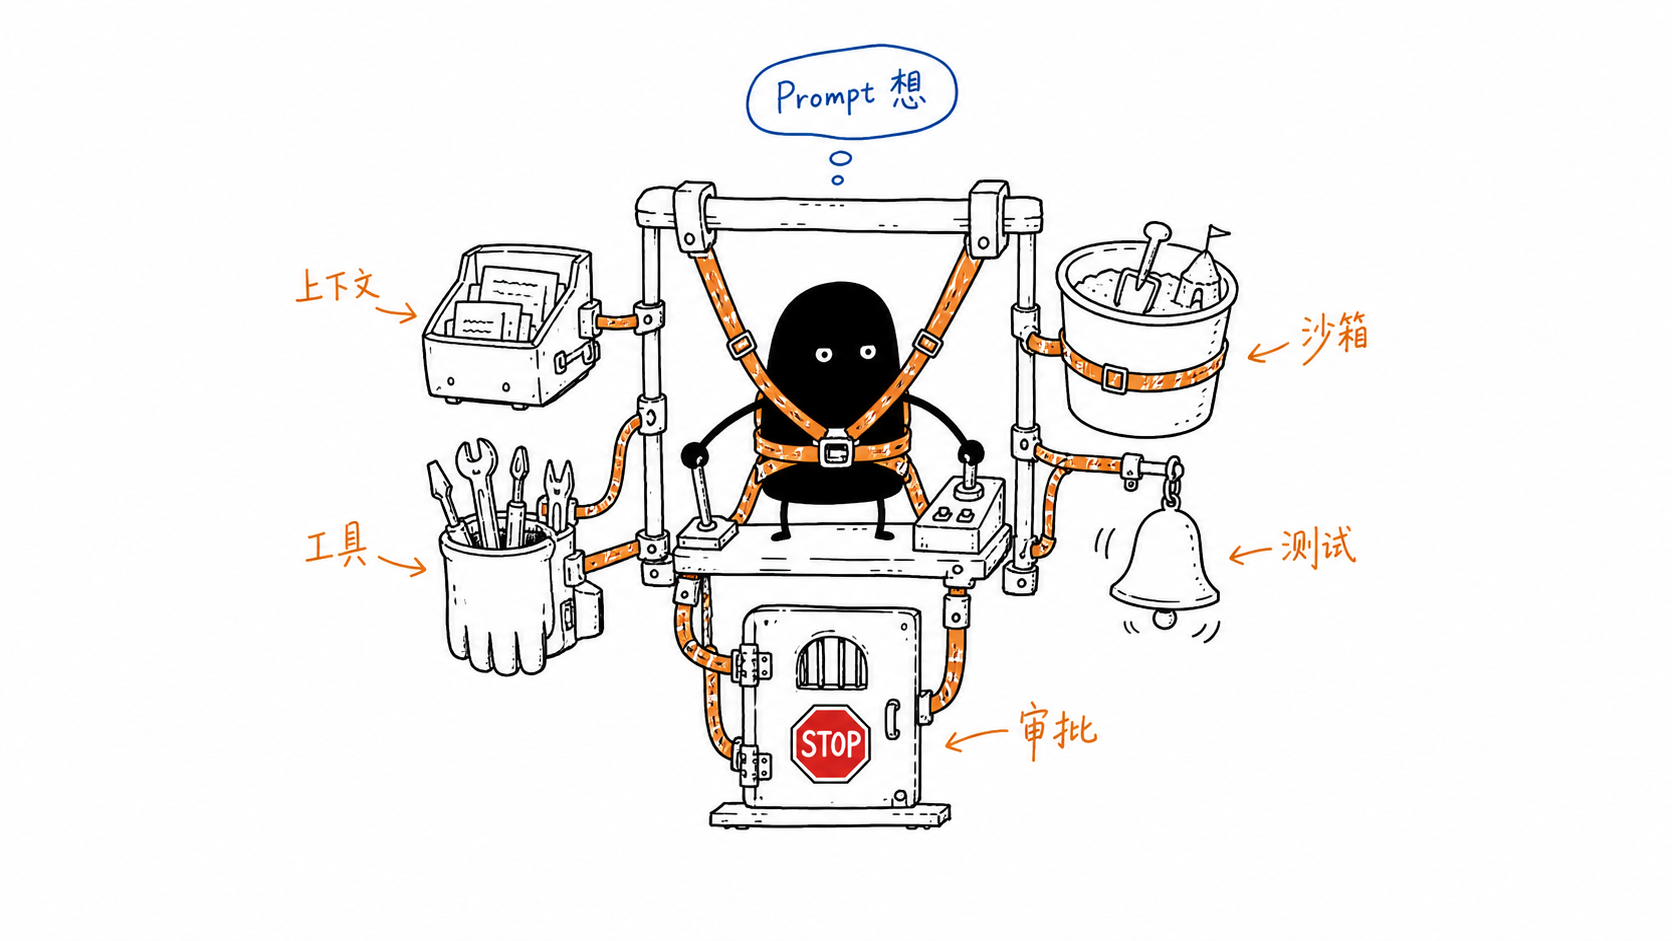
它对人类注意力的价值在于:把那些本来需要人盯的执行细节,变成系统自动承接的流程。没有 harness,人类要盯着 Agent 是否复现了 bug、是否跑了测试、是否重试失败、是否生成了 PR、是否处理了反馈。有了 harness,人类不必盯每一步,只需要在这些点介入:
Agent 缺少上下文
Agent 触碰权限边界
Agent 遇到无法判断的方案分叉
Agent 交付需要 review 的证据包
这就是注意力的重新分配:
不是人类不管了,而是人类不用盯所有执行细节了。
Factor 3:把上下文变成生产资料,减少人类反复解释
以前的文档、issue、README、日志、测试说明等都是“给人看的协作材料”,但如果 Agent 开始执行任务,这些材料就变成了 Agent 的运行燃料。这个时候,上下文就不再只是辅助材料,而是生产资料。
OpenAI 在 Codex App 文章里提到,agents 运行在按项目组织的 separate threads 中,开发者可以在任务之间切换而不丢失上下文;还支持 worktrees,让多个 agents 在同一个 repo 上隔离工作。 Anthropic Managed Agents 把 session 视为事件日志,也说明上下文、状态和环境需要被系统化管理。
这让我觉得:
Agent 时代,代码不是唯一资产。可被 Agent 消化的上下文,也是资产。
如果上下文没有被结构化,人类就要一遍遍给 Agent 解释:
这个模块是干什么的
测试命令怎么跑
哪些文件不能改
哪些方案以前试过
这个 bug 的复现路径是什么
这个需求的非目标是什么
如果上下文被系统化,Agent 可以自己读取项目文档、历史状态、测试结果、工具说明,人类就不需要反复补背景。团队未来需要维护的不只是代码库,还包括:
清晰的 README
明确的架构边界
稳定的测试命令
结构化的 issue 模板
可检索的日志
可执行的规范
机器可读的权限规则
过去文档是知识沉淀,但在Agent 时代,文档也是执行输入,更准确地说:
上下文工程的价值,不只是让 Agent 更聪明,而是减少人类反复解释的注意力消耗。
Factor 4:用权限边界替代实时盯防
Agent 一旦可以执行命令、修改文件、访问网络、调用 API、提交 PR,权限就不再只是“安全团队的配置项”。它直接决定 Agent 能把任务推进到什么程度。权限从安全附属品直接转变为Agent的生产边界。
OpenAI 在 Running Codex safely at OpenAI 中说,coding agents 可以自主 review repositories、run commands、interact with development tools;这些过去是人类直接执行的动作。文章重点讨论了 controls、boundaries 和 telemetry 如何治理真实工作流里的 coding agents。 OpenAI 还专门写了 Windows sandbox,解释 Codex 为什么需要 controlled file access 和 network limits,才能在 Windows 上安全执行。
ServiceNow 的 AI Control Tower 也在解决类似问题:发现每个 AI agent、model 和 identity,治理风险,执行合规,监控 runtime performance,并度量 AI value。 QoderWake 也把 digital employee 拆成 identity、memory、skills、division of labor 和 permission red lines 五层。
所以权限问题不只是以前的能不能访问某个资源,还包括:
能不能修改代码?
能不能运行命令?
能不能联网?
能不能发邮件?
能不能改生产数据?
能不能提交 PR?
能不能部署?
哪些动作必须等人批准?
从注意力角度看,权限边界的价值是:人类不用靠实时盯防来控制风险。
如果没有权限边界,人类只能盯着 Agent 的每一步,防止它越界。如果有权限边界,人类可以把注意力放到更高价值的判断上:
这个任务应不应该授权?
这个操作是不是高风险?
这个 Agent 能不能触达生产环境?
这个异常是否需要升级给人?
一句话就是:
Agent 被允许做什么,决定了它实际上能生产什么;权限边界则决定了人类是否需要一直盯着它。
Factor 5:从 Output 到 Evidence Package
Agent 交付一个 PR,并不等于任务可信地完成了。
原因很简单:人类没有盯完整个执行过程。所以 Agent 必须把判断依据一起交出来。
GitHub Agent HQ 允许用户在 GitHub、GitHub Mobile 和 VS Code 中运行多个 coding agents,并让 agents 异步工作,开发者可以实时跟进,也可以之后 review 结果;GitHub 还强调 agents 会产生 comments、drafts、proposed changes 等可审查 artifacts。 Anthropic 的 evals 文章把 transcript / trace / trajectory 定义为一次 trial 的完整记录,包括输出、工具调用、推理、中间结果和其他交互;它还区分了 final output 和 environment outcome。
这正是我想说的 Evidence Package。
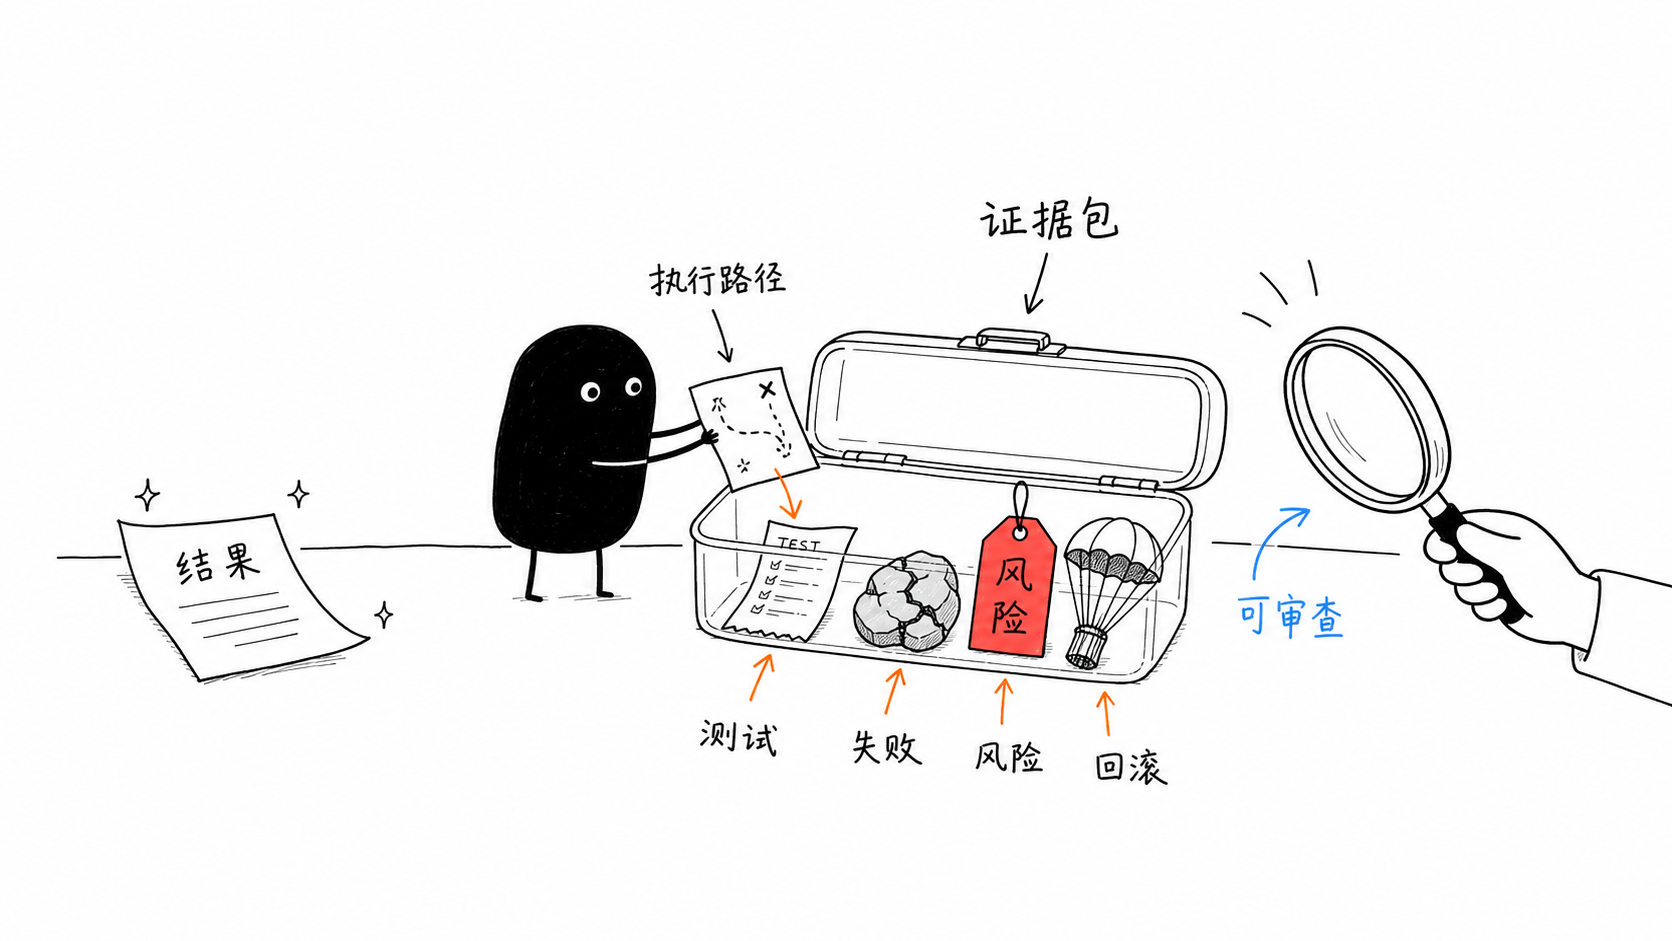
2026 年关于 Agentic-PRs 的研究也能说明这个趋势。AIDev 数据集收集了 932,791 个由 OpenAI Codex、Devin、GitHub Copilot、Cursor、Claude Code 等 agents 生成的 Agentic-PRs,覆盖 116,211 个仓库和 72,189 名开发者;这说明 agent-authored PR 已经成为一个可以被系统研究和治理的软件工程对象。
我现在越来越觉得:
可信 Agent 的核心,不是能生成结果,而是能让人低成本判断结果是否可信。
从注意力角度看,证据包的意义是:
人类不需要重跑全过程
人类不需要重新推理每一步
人类只需要审查关键证据
结果交付把任务交给人类判断,证据交付则帮助人类更快判断。
Factor 6:从 Log 到 Execution Trace / Trajectory Audit
简单说“过程日志化”这个表达还不够,更准确的说法应该是:
Agent 需要留下可审计的 execution trace。
因为 Agent 的风险不一定只体现在最终输出里,很多问题往往会发生在中间过程。
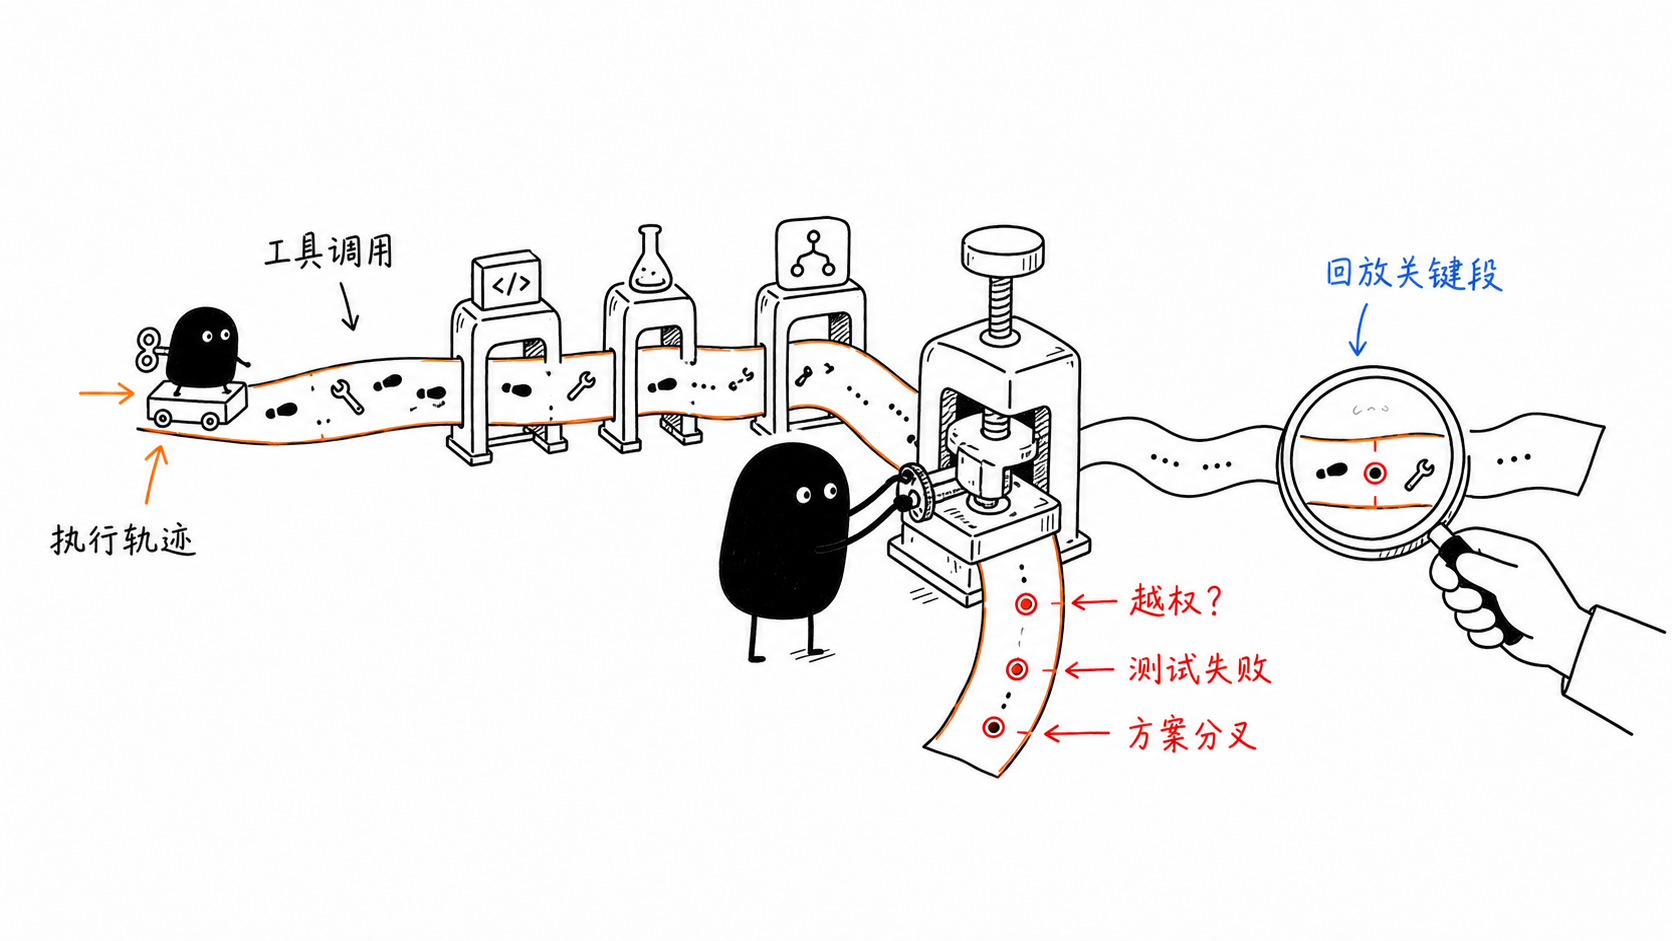
Anthropic 的 evals 文章把 transcript / trace / trajectory 定义为包含 outputs、tool calls、reasoning、intermediate results 等完整 trial record,并建议在 agent evals 中不仅看结果,也要看 transcript。 2026 年的 AI Harness Engineering 论文也提出 trace-based evaluation protocol,把每次 agent run 转换成可审计的 episode package。
如果没有 execution trace,人类就只能看最终结果;而如果有 execution trace,人类可以只在必要时回溯关键路径。
所以我会把原来的“日志”升级成:
Execution Trace(执行轨迹)
Trajectory Audit(轨迹审计)
Episode Package(任务证据包)
它们的价值不是记录一切,而是让人类在需要时能快速回答:
Agent 到底做了什么?
在哪一步失败过?
为什么选择这个方案?
有没有越权?
证据是否支持最终结论?
Factor 7:用 Attention Routing 替代 Human Oversight
我现在不太喜欢把人类角色简单叫做 “human oversight”。
因为 “oversight / supervision” 很容易让人想到:人站在旁边监督 Agent。
但我觉得 Agent 时代的目标不是让人站在旁边,而是让系统知道:
什么时候该打扰人?
打扰哪个人?
给人看什么信息?
希望人做什么判断?
判断之后如何继续执行?
所以我更愿意用一个词:Attention Routing,也就是:把人类注意力路由到真正需要判断的节点。
OpenAI Codex App 的定位就是 command center for agents,用来让开发者同时管理多个 agents、并行运行任务,并处理长期任务。 GitHub Agent HQ 把多个 coding agents 放进 GitHub、GitHub Mobile 和 VS Code 这些已有开发入口中,让用户在自己的时间 review 结果。
这说明问题不再只是如何让 AI 多干一点,而是:如何让人类少看一点,但看得更准
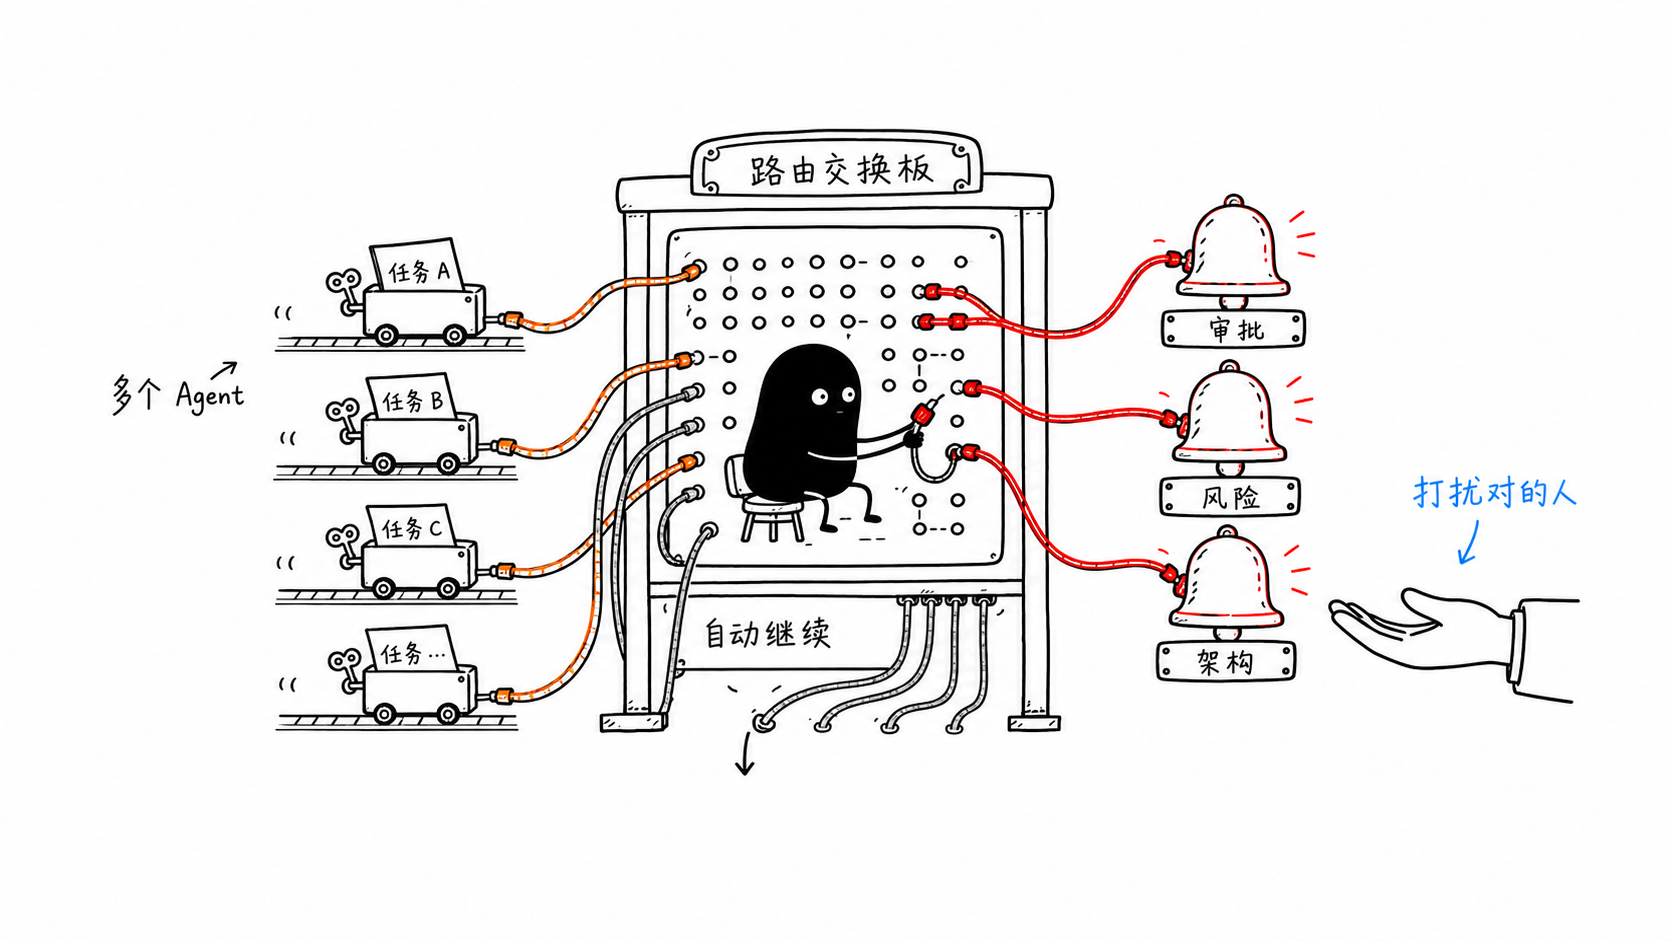
这不是让人类消失,而是把人类移动到更高杠杆的位置。
Factor 8:Distributed Agents 放大了注意力调度问题
还有一个明显趋势是厂家和生态开始往 distributed agents 方向走,这里的“分布式”不是多开几个 Agent 窗口,而是 Agent 开始跨任务、跨工具、跨环境、跨厂商协作。
OpenAI Codex App 支持多个 agents 通过 separate threads 和 worktrees 在同一 repo 上隔离工作,避免并行任务互相冲突。 GitHub Agent HQ 把 Copilot、Claude、Codex 放进同一个开发工作流,开发者可以选择不同 agent 处理 issues 和 PRs。 Anthropic 的 2026 年并行 Claude 实验则更直接:16 个 Claude agents、近 2,000 个 Claude Code sessions、约 100,000 行 Rust C compiler 代码,重点是研究 long-running autonomous agent teams 的 harness、测试和并行工作结构。
A2A 的 2026 年进展也能放在这个背景下理解。Linux Foundation 2026 年 4 月称,A2A 已经有超过 150 个组织支持,并进入主要云平台和企业生产使用;A2A 的目标是让 agents 跨工具、供应商和环境进行协调。
这说明,Agent 正在从单体工具走向分布式执行网络,而分布式 Agent 会进一步放大注意力调度问题。
单个 Agent 时代,人类还可以盯一个窗口,但是在分布式 Agent 时代,人类面对的是:多个 Agent、多个任务、多个权限边界、多个执行轨迹、多个证据包、多个冲突点、多个审批请求
这时真正的问题将不再是能不能让更多 Agent 同时干活,而是:
任务如何路由?
上下文如何隔离?
权限如何最小化?
冲突如何处理?
证据如何聚合?
人类注意力如何只被关键事件打断?
所以:
执行越分布式,人类越不能盯过程;执行越分布式,系统越需要状态、权限、轨迹、证据和注意力路由。
Agent 的核心不是“模型自己循环”,更准确地说:
Agent 是一个围绕任务状态运行、由 harness 约束、以 execution trace 和 evidence package 交付、并通过 attention routing 调用人类判断的人机执行系统。
尾声
1. “Agent 会干活”不是终点
因为 2026 年的很多产品和论文已经在回答“Agent 会不会干活?”这个问题,所以更值得我们关心的是:
它如何被启动?
如何被约束?
如何被观察?
如何被恢复?
如何被验收?
如何被治理?
什么时候应该让人介入?
那么由此对 Agent 下一阶段的判断就应该是:
Agent 的新变革,不是更会干活,而是让人类注意力从过程监督迁移到关键判断。
2. “执行系统”会取代“聊天窗口”成为核心界面
如果 Agent 只是聊天窗口,用户就必须盯着每一步,但如果 Agent 是执行系统,用户管理的是:任务、状态、上下文、权限、轨迹、证据、审批、结果
这也是我为什么会把 Codex App、Symphony、GitHub Agent HQ、A2A、Managed Agents、AI Control Tower 看成同一类信号。它们不是在做同一个产品,但都在补同一套执行控制系统。
3. 工程师的新能力不是“会 prompt”,而是“会设计 Attention Routing”
Prompt 仍然重要,但它只是局部,更重要的是:
任务如何拆
上下文如何给
权限如何控
测试如何跑
失败如何恢复
证据如何看
人类何时介入
这才是 Agentic Engineering 时代真正稀缺的工程能力。
Reference
[1] OpenAI, Introducing the Codex app, 2026.
[2] OpenAI, An open-source spec for Codex orchestration: Symphony, 2026.
[3] OpenAI, Harness engineering: leveraging Codex in an agent-first world, 2026.
[4] Anthropic, Demystifying evals for AI agents, 2026.
[5] Anthropic, Scaling Managed Agents: Decoupling the brain from the hands, 2026.
[6] Anthropic, Building a C compiler with a team of parallel Claudes, 2026.
[7] GitHub, Pick your agent: Use Claude and Codex on Agent HQ, 2026.
[8] GitHub Changelog, Agent activity in GitHub Issues and Projects, 2026.
[9] Microsoft WorkLab, Agents, human agency, and the opportunity for every organization, 2026.
[10] Linux Foundation, A2A Protocol Surpasses 150 Organizations, Lands in Major Cloud Platforms, and Sees Enterprise Production Use in First Year, 2026.
[11] ServiceNow, AI Control Tower, 2026.
[12] AI Harness Engineering: A Runtime Substrate for Foundation-Model Software Agents, arXiv, 2026.
[13] Agentic Agile-V: From Vibe Coding to Verified Engineering in Software and Hardware Development, arXiv, 2026.
[14] AIDev: Studying AI Coding Agents on GitHub, arXiv, 2026.